Въведение
robots.txt е малък файл с потенциално голям ефект.
С няколко реда можеш да кажеш на crawler-и като Googlebot кои части от сайта могат да бъдат обходени. Но същата простота прави файла лесен за грешно конфигуриране.
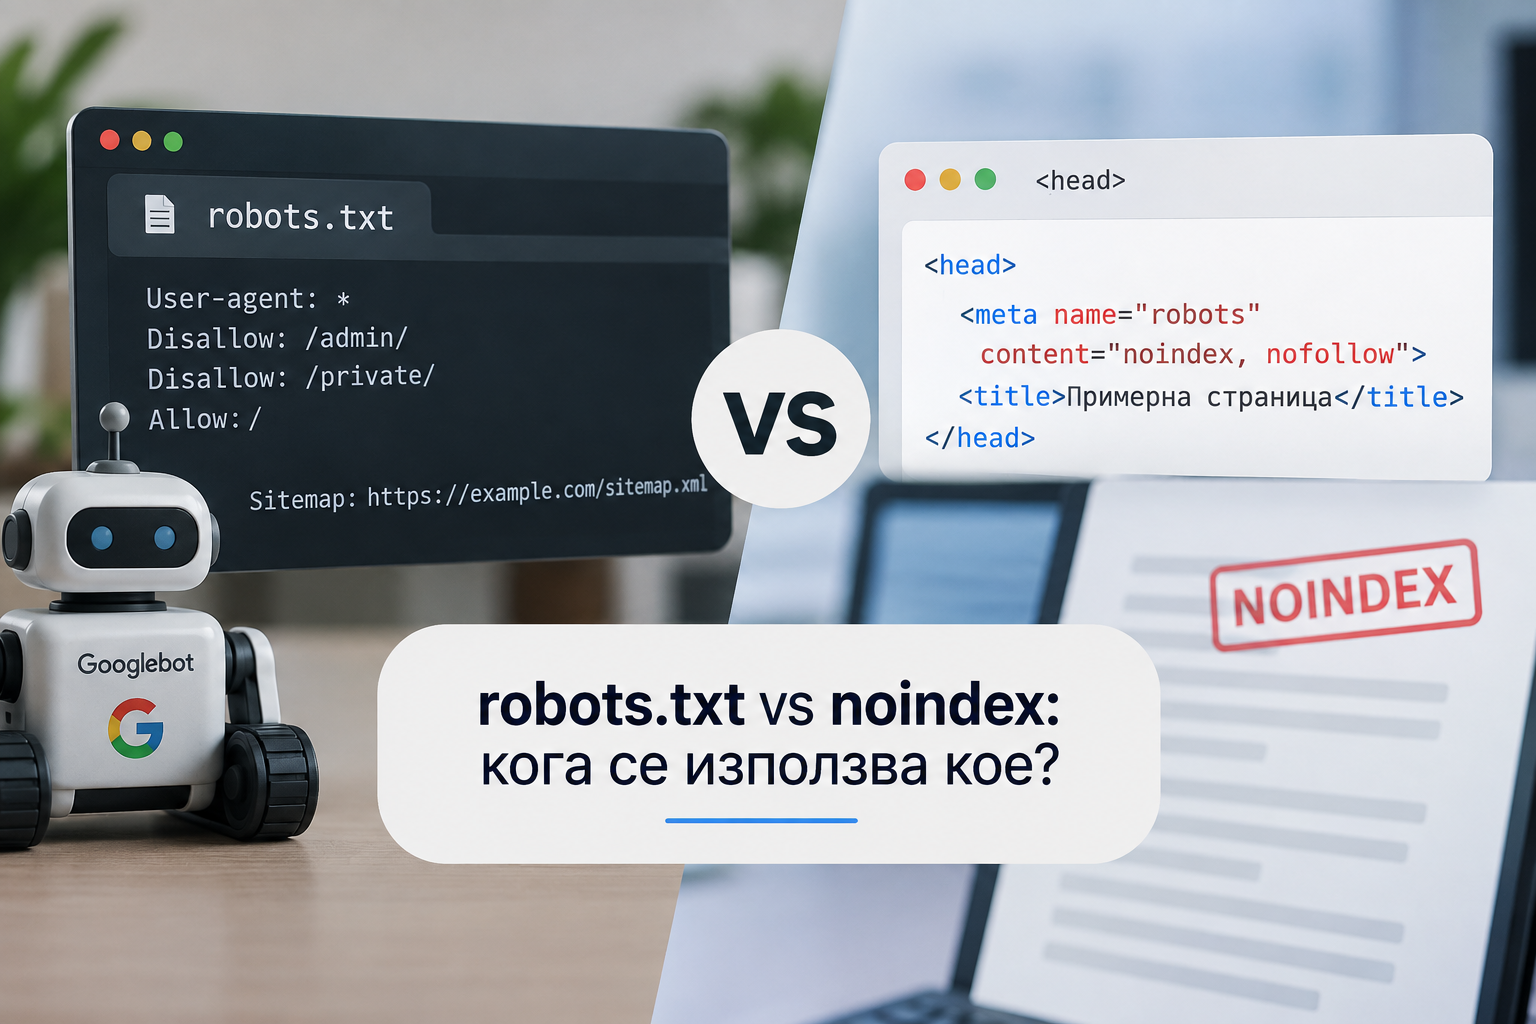
Важно е да разграничим две неща: robots.txt контролира основно crawling-а, а не директно indexing-а. Google изрично посочва, че URL, блокиран от crawling, все пак може в определени ситуации да се появи в Search без нормален snippet. За надеждно предотвратяване на индексиране се използват други механизми като noindex или контрол на достъпа.
Ето седем грешки, които си струва да провериш.
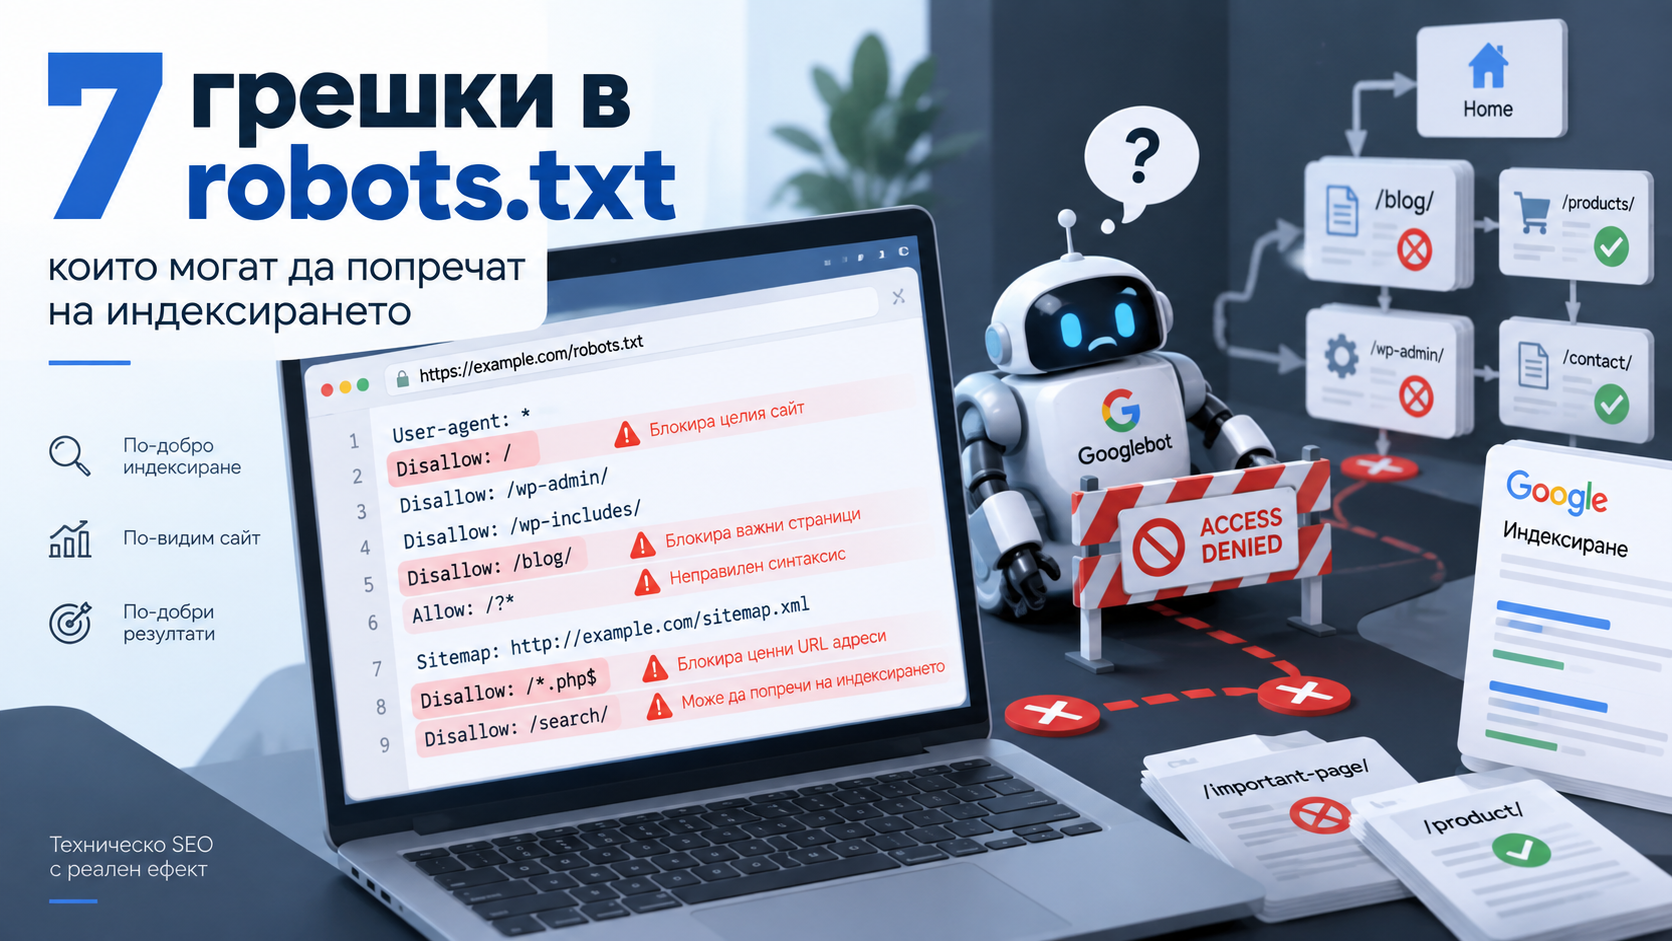
1. Блокираш целия сайт с Disallow: /
Това е най-очевидната и една от най-сериозните грешки:
User-agent: *
Disallow: /
Това казва на crawler-ите, които спазват файла, да не обхождат сайта.
Такова правило може да е полезно в staging среда, но ако попадне в production по погрешка, важните страници могат да останат недостъпни за crawling.
Ако сайтът трябва да бъде публичен, винаги провери live файла:
https://yourdomain.com/robots.txt
особено след миграция, redesign или прехвърляне от staging към production.
2. Използваш robots.txt, за да премахнеш страница от Google
Много хора предполагат, че:
Disallow: /private-page/
означава:
„Google няма да показва тази страница.“
Това не е точно така.
Google обяснява, че robots.txt не е надежден механизъм за премахване на страница от Search. Ако URL бъде открит чрез други връзки, той може да остане известен на Google и потенциално да се появи без нормално извлечено съдържание.
Ако целта е страницата да не бъде индексирана, използвай noindex или реален access control.
3. Блокираш страница в robots.txt и едновременно разчиташ на noindex
Това е особено коварна комбинация.
Например:
User-agent: *
Disallow: /thank-you/
а самата страница има:
<meta name="robots" content="noindex">
Проблемът е, че ако Googlebot не може да crawl-не страницата, може изобщо да не види noindex.
Google изрично посочва, че страницата трябва да бъде достъпна за crawler-а, за да може noindex да бъде прочетен и приложен.
Ако искаш URL да бъде премахнат от индекса, не блокирай самата страница чрез robots.txt само заради noindex.
4. Блокираш CSS, JavaScript или други важни ресурси
При модерни React/Next.js сайтове това е особено важно.
Google обработва JavaScript приложения чрез crawling, rendering и indexing. Ако важни JS/CSS ресурси са блокирани, Google може да не види страницата по начина, по който я вижда потребителят.
Например твърде агресивно правило като:
User-agent: *
Disallow: /assets/
може да е проблем, ако в тази директория има критичен JavaScript или CSS.
Точно затова при Website Temple премахнахме блокиране на Next.js ресурсите от собствения ни robots.txt.
Не блокирай ресурс само защото изглежда „технически“. Провери дали е нужен за rendering.
5. Използваш грешен path или забравяш, че стойностите са case-sensitive
При robots.txt стойностите на path правилата са чувствителни към главни и малки букви.
Например:
Disallow: /Admin/
не е непременно същото като:
/admin/
Google документира, че имената на директивите не са case-sensitive, но path стойностите са.
Също така path-ът трябва да започва от root:
Disallow: /admin/
а не:
Disallow: admin/
При големи сайтове това е лесен начин да мислиш, че блокираш нещо, а реално правилото да не съвпада с URL-ите, които очакваш.
6. Разчиташ на неподдържани директиви
Не всичко, което се среща в robots.txt файлове по интернет, се поддържа от Google.
Например:
Crawl-delay: 10
не се обработва от Googlebot. Google също не поддържа noindex като robots.txt директива.
Актуално Google поддържа основно:
User-agent
Allow
Disallow
Sitemap
за своята robots.txt интерпретация.
Ако копираш стар template от интернет, можеш да получиш фалшиво усещане, че контролираш crawler-а, когато реално директивата се игнорира.
7. robots.txt е на грешно място или важи за друг host
Файлът трябва да бъде точно в root на съответния host:
https://example.com/robots.txt
Не:
https://example.com/files/robots.txt
И правилата важат само за конкретната комбинация от protocol, host и port, където е публикуван файлът. https://example.com/robots.txt не управлява автоматично https://shop.example.com/ или друг subdomain.
Това е особено важно при:
- subdomains;
- staging сайтове;
-
wwwи non-www; - отделни приложения;
- CDN/preview domains.
Бонус: забравяш Sitemap директивата
Липсата на:
Sitemap: https://example.com/sitemap.xml
не означава автоматично SEO проблем, но е пропусната възможност.
Google, Bing и други големи search engines поддържат Sitemap полето в robots.txt. URL-ът трябва да е абсолютен и може да сочи към sitemap или sitemap index.
Това е особено полезно, когато искаш crawler-ите лесно да открият официалната карта на сайта.
Как да провериш дали robots.txt ти е правилен
Най-лесният начин е да не разчиташ само на визуална проверка.
Можеш да използваш безплатната Проверка на robots.txt на Website Temple:
https://website-temple.com/resources/robots-txt-tester
Въвеждаш сайта, избираш crawler и конкретен URL и виждаш дали достъпът е позволен или блокиран.
Ако още нямаш robots.txt:
https://website-temple.com/resources/robots-txt-generator
може да ти помогне да създадеш начална конфигурация.
Какво да провериш след промяна
След редакция на robots.txt провери най-важните си URL-и през Google Search Console → URL Inspection.
Google препоръчва URL Inspection като начин да видиш дали Google може да crawl-не и render-не страницата и кои ресурси са достъпни.
После провери:
- началната страница;
- основните service/product pages;
- blog/article pages;
- CSS/JS ресурси, ако имаш custom правила;
- robots.txt;
- sitemap.xml;
- AI crawler правилата, ако използваш такива.
Най-сигурното правило: не блокирай нещо, ако не знаеш защо
robots.txt не трябва да бъде списък с произволни технически директории.
Всяко Disallow правило трябва да има ясна причина.
Ако не можеш да обясниш:
„Защо този crawler не трябва да вижда този path?“
по-добре първо провери какво съдържа URL структурата.
При грешна конфигурация една директива може да повлияе на стотици или хиляди URL-и.