Въведение
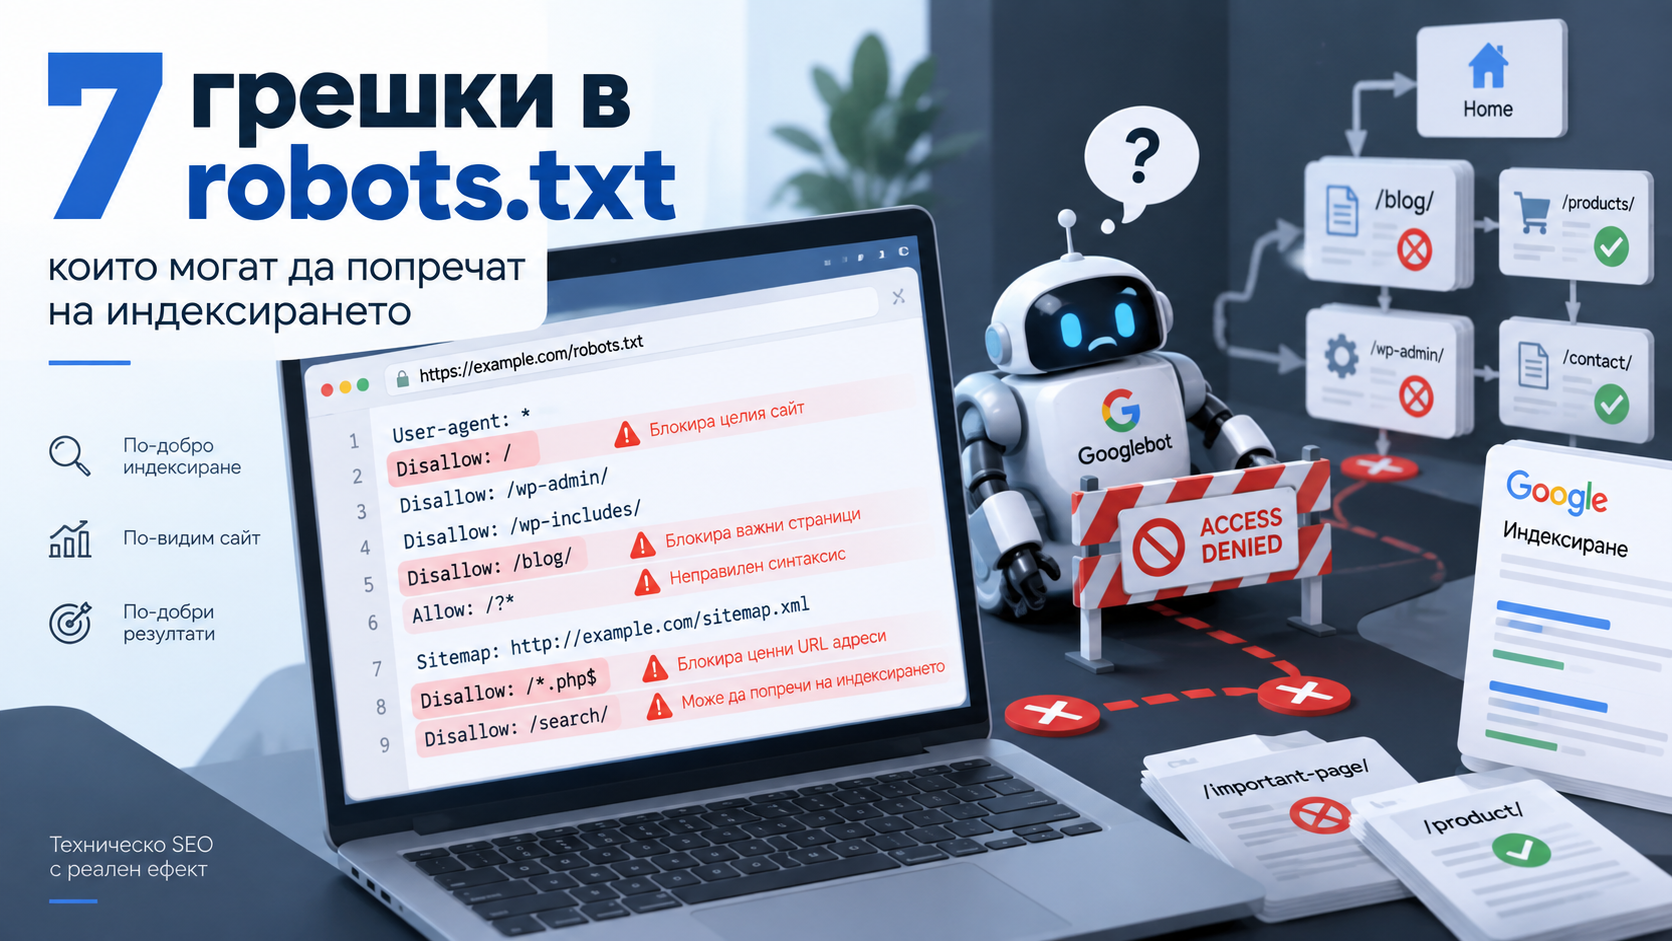
robots.txt и noindex често се използват като че ли правят едно и също нещо.
Не го правят.
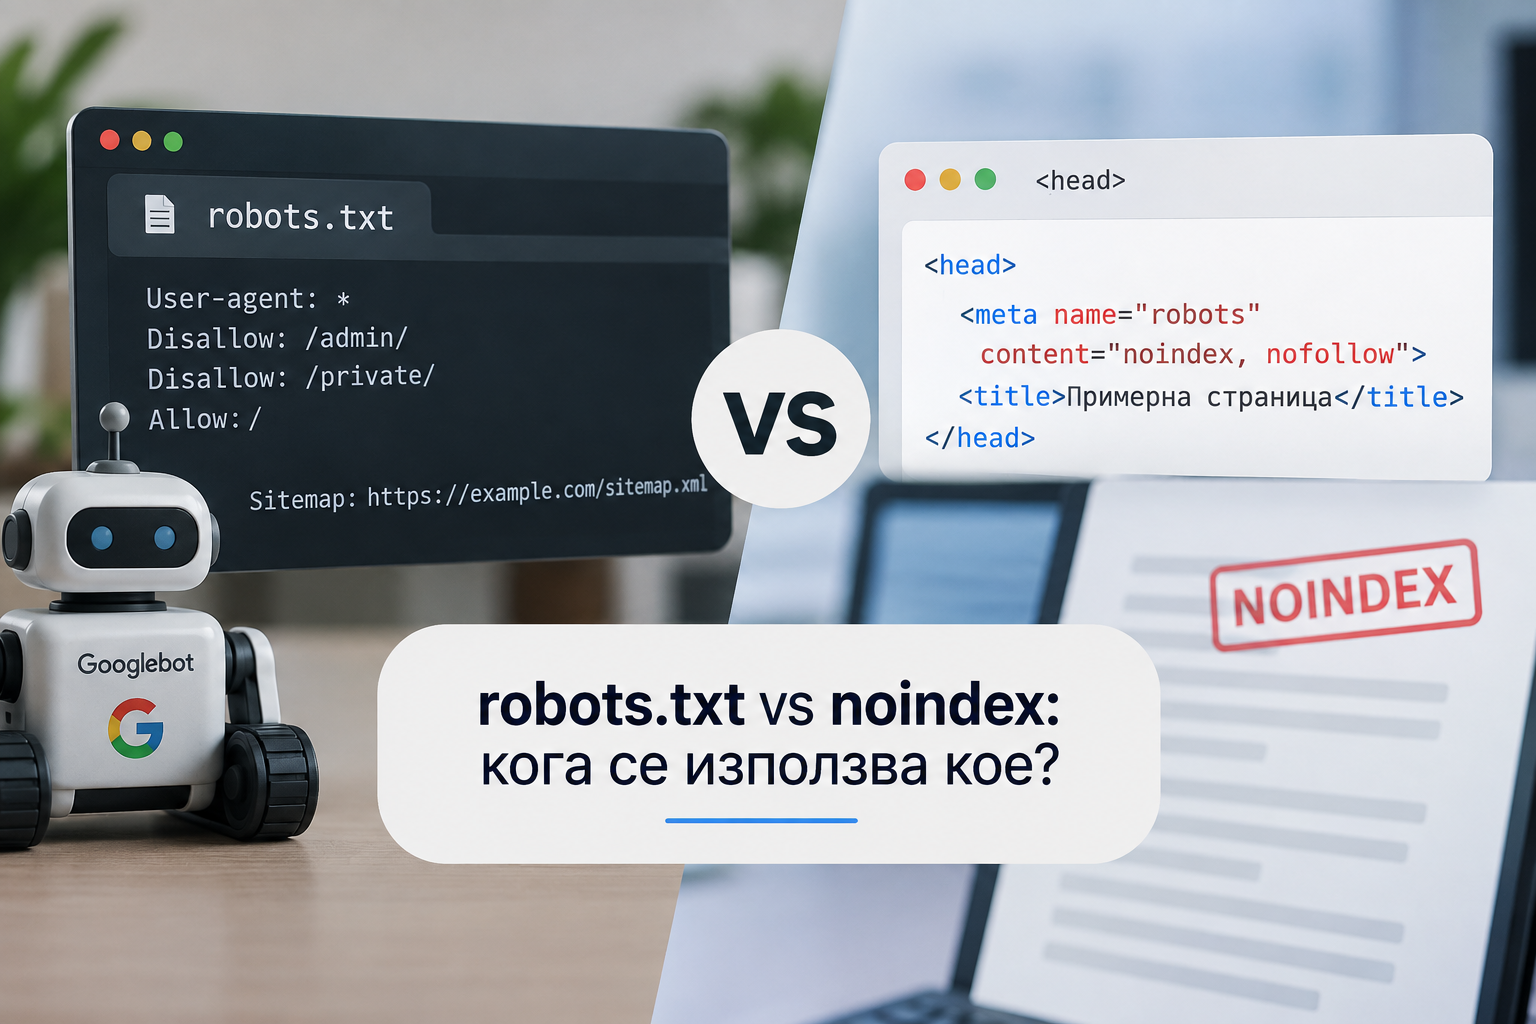
robots.txt казва на crawler-а дали може да достъпи URL, докато noindex казва на search engine-а да не включва съдържанието в резултатите си.
Тази разлика е критична. Google изрично описва robots.txt като инструмент основно за управление на crawling traffic, а не като механизъм за скриване на web страници от Search. За премахване на страница от Search препоръчва noindex, password protection или друг подходящ механизъм.
Какво контролира robots.txt?
Файлът:
https://example.com/robots.txt
съдържа правила към crawler-и.
Например:
User-agent: Googlebot
Disallow: /admin/
казва на Googlebot да не обхожда URL-и под:
/admin/
Това е контрол върху crawling.
Google не трябва да fetch-ва съдържанието на тези страници.
Но това не означава задължително, че самият URL никога няма да бъде видян в Search. Ако Google открие URL чрез външна или вътрешна връзка, може да знае за него и да го покаже без нормален snippet.
Какво контролира noindex?
noindex се задава върху самата страница.
Най-често:
<meta name="robots" content="noindex">
или чрез HTTP response header:
X-Robots-Tag: noindex
Когато Googlebot crawl-не страницата и види правилото, Google трябва да премахне тази страница от Search results, независимо дали други сайтове линкват към нея.
Това е контрол върху indexing.
Най-кратката разлика
Можеш да мислиш за тях така:
robots.txt
„Не отваряй тази врата.“
noindex
„Можеш да влезеш и да прочетеш страницата, но не я показвай в индекса.“
Точно затова двете правила не трябва да се използват механично едно върху друго.
Защо Disallow + noindex може да не работи?
Представи си следната конфигурация.
В robots.txt:
User-agent: *
Disallow: /thank-you/
А в самата страница:
<meta name="robots" content="noindex">
Изглежда логично:
„Блокирам я навсякъде.“
Но ако crawler-ът спази Disallow, той няма да отвори страницата.
Ако не я отвори, няма как да прочете noindex.
Google изрично предупреждава за това: за noindex да бъде ефективен, страницата не трябва да бъде блокирана от robots.txt и трябва да бъде достъпна за crawler-а.
Затова, ако целта е:
„Тази страница не трябва да бъде в Google.“
обикновено правилният модел е:
<meta name="robots" content="noindex">
без:
Disallow
за същия URL.
Кога да използваш robots.txt?
robots.txt е подходящ, когато не искаш crawler да прекарва ресурс в определени URL-и.
Примери:
- вътрешни search резултати;
- faceted navigation;
- технически параметри;
- admin paths;
- crawl traps;
- определени crawler-и;
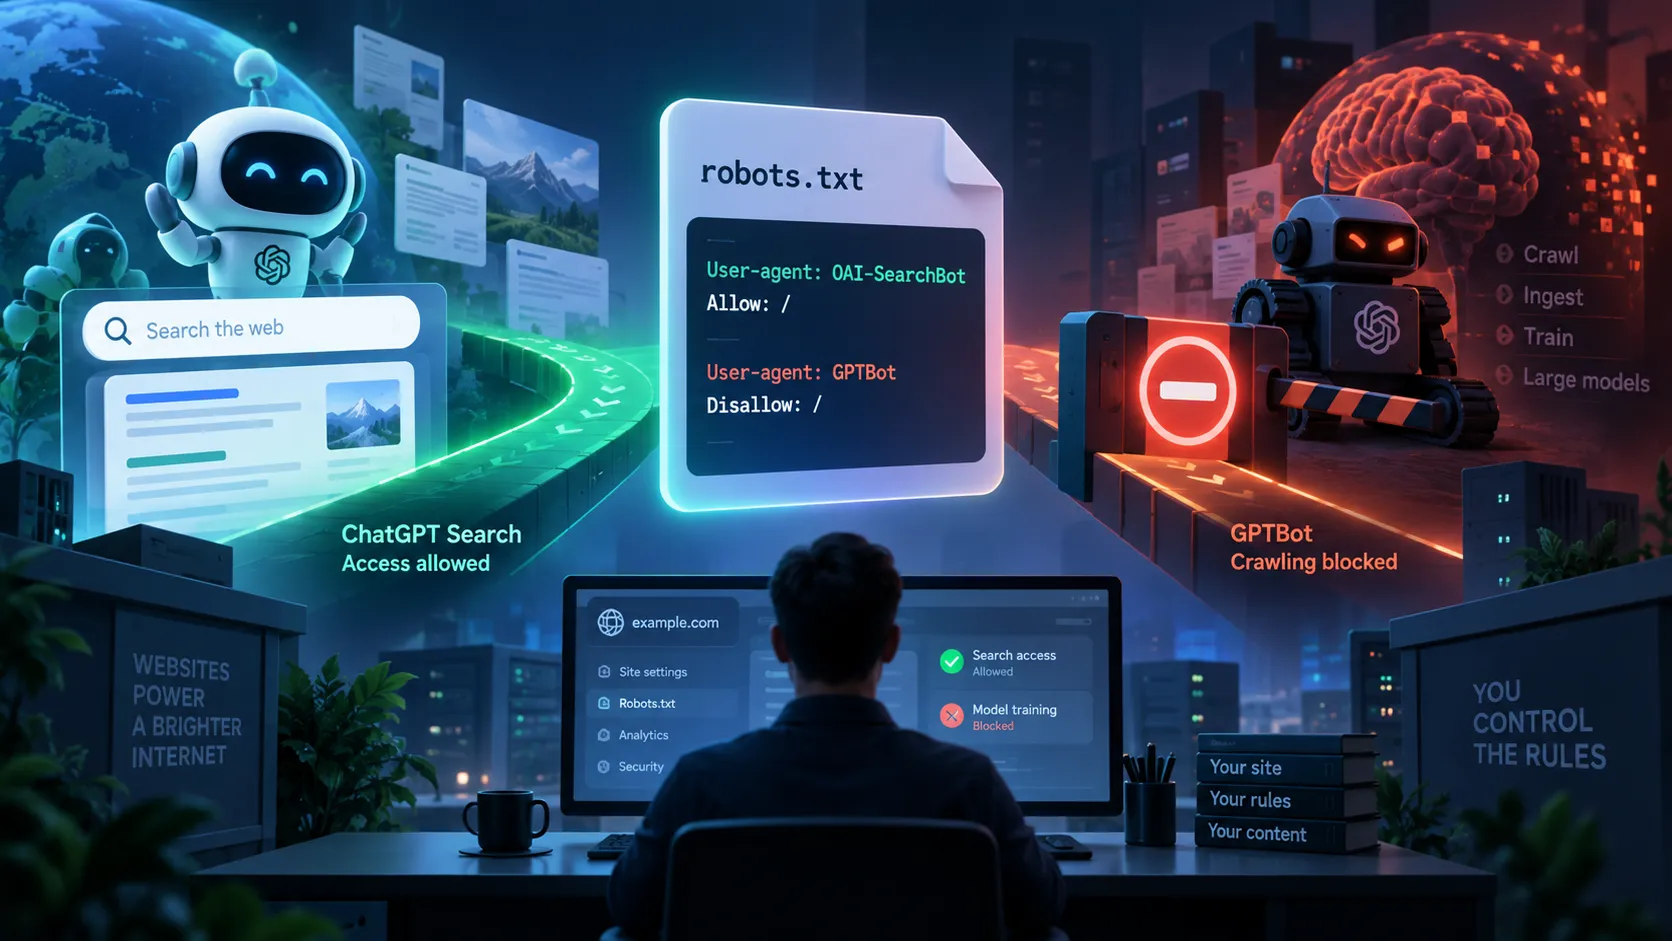
- AI bots, ако искаш да контролираш конкретния им достъп.
Например:
User-agent: *
Disallow: /internal-search/
или:
User-agent: GPTBot
Disallow: /
robots.txt е особено полезен за crawler management, а не за управление на видимостта на отделна страница в SERP.
Кога да използваш noindex?
noindex е правилният избор, когато страницата може да бъде публично достъпна, но не искаш да бъде в search index.
Типични примери:
- thank-you pages;
- campaign landing pages без SEO стойност;
- internal utility pages;
- някои account-related pages;
- дублиращи варианти, когато няма по-подходящ canonical подход;
-
определени PDF или други non-HTML assets чрез
X-Robots-Tag.
Google поддържа noindex както чрез HTML meta tag, така и чрез HTTP response header.
А кога не е достатъчен нито един от двата?
Ако съдържанието е:
- поверително;
- административно;
- клиентско;
- платено;
- съдържа лични данни;
не използвай robots.txt или noindex като security механизъм.
robots.txt е публичен файл.
А noindex не спира човек да отвори URL-а.
За private content използвай реален access control:
- authentication;
- authorization;
- password protection;
- private storage;
- server-side permissions.
Google също отбелязва, че robots.txt не може да принуди злонамерен crawler да спазва правилата.
robots.txt vs noindex vs canonical
Има още едно често объркване.
canonical също не е заместител на noindex.
Canonical казва:
„Това е предпочитаната версия на сходно или дублиращо съдържание.“
noindex казва:
„Не искам тази страница в индекса.“
robots.txt казва:
„Не crawl-вай този URL.“
Това са три различни сигнала.
Ако имаш две почти еднакви product страници и едната е предпочитаната версия, canonical може да е правилният инструмент.
Ако имаш thank-you page, която няма причина да присъства в Google, noindex е по-логичен.
Ако имаш огромен набор от технически URLs, които crawler-ът не трябва да обхожда, robots.txt може да е подходящ.
Практически примери
Thank-you страница
Цел:
Да е достъпна след submit, но да не е в Google.
Използвай:
<meta name="robots" content="noindex">
Не е необходимо да я блокираш в robots.txt.
Admin панел
Цел:
Да бъде частен.
Не разчитай само на:
Disallow: /admin/
Използвай authentication.
Можеш допълнително да имаш robots.txt правило, но това не е security layer.
Вътрешни search резултати
Цел:
Да не се crawl-ват огромни комбинации от URL-и.
robots.txt може да е подходящ:
User-agent: *
Disallow: /search/
PDF файл, който не трябва да се индексира
PDF няма HTML <head>.
Използвай HTTP header:
X-Robots-Tag: noindex
Google изрично поддържа X-Robots-Tag за non-HTML файлове.
Как да провериш какво вижда Google?
За конкретна страница използвай:
Google Search Console → URL Inspection
Провери дали:
- URL може да бъде crawl-нат;
- Google е видял noindex;
- robots.txt блокира URL;
- canonical е правилен.
Ако редактираш noindex, Google трябва отново да crawl-не страницата, преди да види промяната. Google отбелязва, че това понякога може да отнеме време, а URL Inspection може да бъде използван за проверка и request за recrawl.
Как да провериш robots.txt преди промяна
Website Temple има безплатна:
Проверка на robots.txt
https://website-temple.com/resources/robots-txt-tester
Можеш да въведеш URL и crawler и да провериш дали правилата позволяват достъп.
Ако още нямаш файл или искаш да изградиш правилата отначало:
https://website-temple.com/resources/robots-txt-generator
Кое правило да избера?
Използвай този прост модел:
Искаш crawler-ът да не посещава URL?
→ robots.txt
Искаш страницата да бъде crawl-ната, но да не присъства в Search?
→ noindex
Искаш съдържанието да е частно?
→ access control
Имаш сходни версии и искаш да посочиш предпочитана версия?
→ canonical
Най-важното е първо да определиш какъв проблем решаваш, вместо просто да добавяш SEO директиви.