Въведение
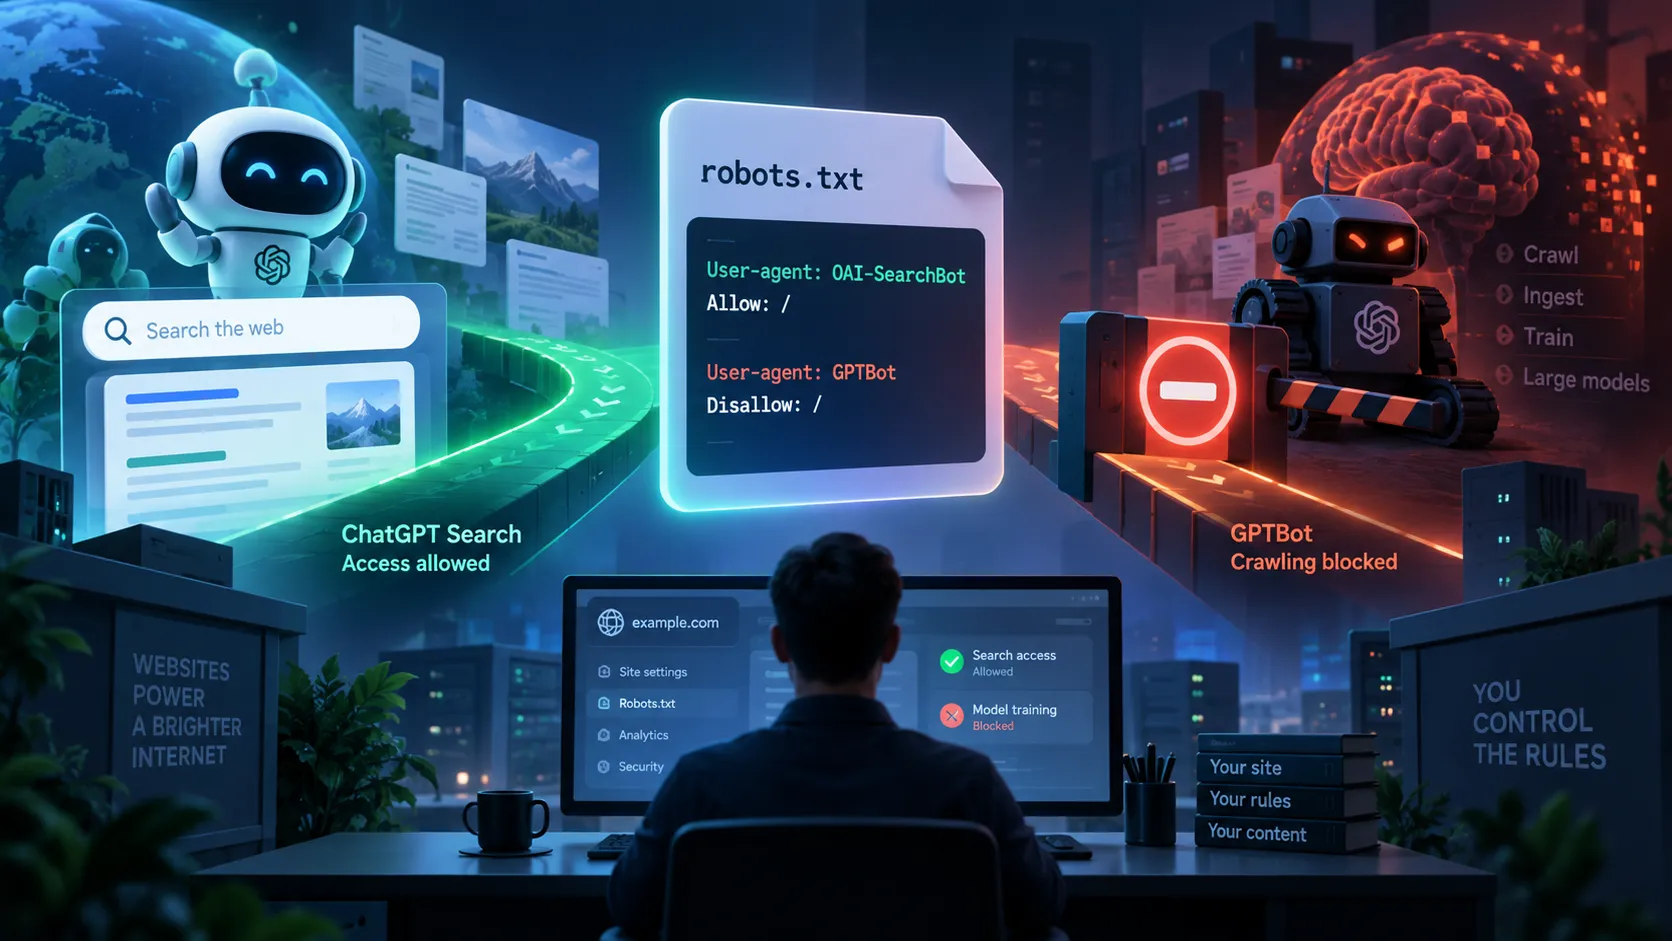
ChatGPT Search и GPTBot не са едно и също нещо. OpenAI използва различни crawler-и за различни цели, което позволява на собствениците на сайтове да управляват достъпа по-прецизно.
Ако искаш страниците ти да могат да бъдат откривани и цитирани в ChatGPT Search, важно е да не блокираш OAI-SearchBot. Ако обаче не искаш публичното съдържание на сайта ти да бъде обхождано от GPTBot за подпомагане на обучението на модели, можеш да го блокираш отделно чрез robots.txt.
Това означава, че не е нужно да избираш между „видимост в ChatGPT“ и „пълен достъп за всички OpenAI crawler-и“. Двата crawler-а могат да бъдат управлявани независимо. OpenAI официално посочва OAI-SearchBot като crawler, свързан с ChatGPT Search, а GPTBot може да обхожда публично съдържание за подпомагане на обучението на моделите.
Каква е разликата между OAI-SearchBot и GPTBot?
OAI-SearchBot е crawler-ът, който OpenAI използва за откриване на публично съдържание, което може да бъде използвано в ChatGPT Search. Ако сайтът блокира този bot, това може да ограничи възможността съдържанието му да бъде откривано и използвано в отговори и search резултати в ChatGPT. Разрешаването му обаче не е гаранция, че дадена страница ще бъде показана — то просто позволява тя да бъде обходена.
GPTBot има различна роля. OpenAI посочва, че собствениците на сайтове могат да го блокират чрез стандартни web controls като robots.txt, ако не желаят публичното им съдържание да бъде достъпвано за потенциално използване при обучение на модели.
Това разделение е важно, защото позволява да контролираш двете цели поотделно.
Как да позволиш ChatGPT Search и да блокираш GPTBot
В основната директория на сайта ти трябва да има файл:
/robots.txt
Например:
https://example.com/robots.txt
Добави следните правила:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
С тази конфигурация казваш:
-
OAI-SearchBotможе да обхожда публичните страници; -
GPTBotне трябва да обхожда сайта.
Това не блокира Google или другите crawler-и, освен ако няма други правила в robots.txt.
Какво ако вече имаш правило User-agent: *?
Много сайтове използват базова конфигурация като:
User-agent: *
Allow: /
или:
User-agent: *
Disallow:
Това по подразбиране позволява crawling.
Ако искаш GPTBot да бъде изключение, можеш да добавиш отделна, по-специфична група:
User-agent: *
Allow: /

User-agent: GPTBot
Disallow: /
При robots.txt правилата могат да бъдат задавани за конкретни user-agent-и, вместо всички crawler-и да получават еднакъв достъп. Google използва същия основен модел с user-agent, allow, disallow и sitemap.
Трябва ли изрично да добавяш OAI-SearchBot?
Не винаги.
Ако текущият ти robots.txt вече позволява всички crawler-и и нямаш друго техническо ограничение, OAI-SearchBot може вече да има достъп.
Изричното правило обаче прави намерението ти ясно и е полезно, когато имаш по-сложен robots.txt, firewall, CDN или bot protection.
Важно е да провериш не само robots.txt. OpenAI предупреждава, че WAF, CDN, Cloudflare правила, CAPTCHA, rate limits или други anti-bot системи също могат да блокират crawler-и, дори robots.txt да ги позволява.
Как да провериш дали правилата работят
Не е нужно да четеш robots.txt на око и да гадаеш кое правило ще се приложи.
Можеш да използваш нашата Проверка на robots.txt, да въведеш сайта си и да провериш конкретен URL за различни crawler-и.
Линк:
https://website-temple.com/resources/robots-txt-tester
Например можеш да провериш:
OAI-SearchBot
и след това:
GPTBot
за една и съща страница.
Ако все още нямаш robots.txt, можеш да използваш:
https://website-temple.com/resources/robots-txt-generator
за да генерираш файл и правила за Googlebot, ChatGPT Search, GPTBot и други crawler-и.
Какво robots.txt не прави
robots.txt контролира crawling-а. Това не е security система и не прави дадена страница частна.
Ако имаш административна страница, чувствителни документи или съдържание, което не трябва да е публично достъпно, не разчитай на:
Disallow: /private/
като защита.
Използвай authentication и реален access control.
Също така crawling и indexing не са едно и също нещо. Google например изрично посочва, че URL, блокиран през robots.txt, все пак може в определени ситуации да се появи като URL в резултатите без съдържателен snippet.
А ако изобщо не искаш страницата да се появява в Search?
Тогава robots.txt не е правилният инструмент.
За страници, които не трябва да бъдат индексирани, се използва noindex.
И тук има един важен детайл: crawler-ът трябва да може да отвори страницата, за да види noindex meta tag-а. Ако едновременно я блокираш през robots.txt, crawler-ът може да не види директивата.
OpenAI също описва подобна логика: ако не искаш даден URL да бъде показван, използвай noindex, като страницата трябва да остане достъпна за crawler-а, за да може той да прочете директивата.
Коя конфигурация е подходяща за повечето бизнес сайтове?
Ако искаш сайтът ти да бъде откриваем както в Google, така и в AI search системи, разумният старт е:
User-agent: *
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
След това правилата могат да се донастроят според конкретния сайт.
Например /admin/, вътрешни search резултати или технически URL-и може да имат различни правила.
Не копирай автоматично robots.txt от друг сайт. Един e-commerce магазин, SaaS приложение и корпоративен сайт могат да имат напълно различни crawl изисквания.
Провери конфигурацията преди да я публикуваш
Една малка грешка в robots.txt може да блокира много повече, отколкото си планирал.
Преди да качиш промени:
- провери live robots.txt;
- тествай важните URL-и;
- провери Googlebot;
- провери OAI-SearchBot;
- провери GPTBot;
- увери се, че sitemap адресът е правилен.
Можеш да направиш това без регистрация чрез Проверката на robots.txt на Website Temple:
https://website-temple.com/resources/robots-txt-tester
А ако файлът още не съществува, започни с: